这两年接了几个国产化替代的迁移项目,事后复盘算过一笔账:搬数据本身占整个项目周期不到 20%,剩下 80% 全耗在语法改写、存储过程翻译和双轨验证上。这篇把踩过的坑按阶段理一遍,顺序大致就是项目该走的顺序。
一、时间到底花在哪
第一次接这类项目,我也习惯性地把精力放在数据搬迁方案上——用什么工具导、怎么保一致、中断窗口多长。方案写得很漂亮,评估阶段三天就交了。
真正开工才发现不对。数据迁移是个标准化程度很高的活儿,工具能兜住七成;卡住项目的是那些散落在代码和数据库深处的东西:几个 2000 行存储过程、几段拼字符串的动态 SQL、某个业务为了”Oracle 行为”故意写的空字符串判断。这些东西静态扫描一次容易,逐个确认语义要几周。
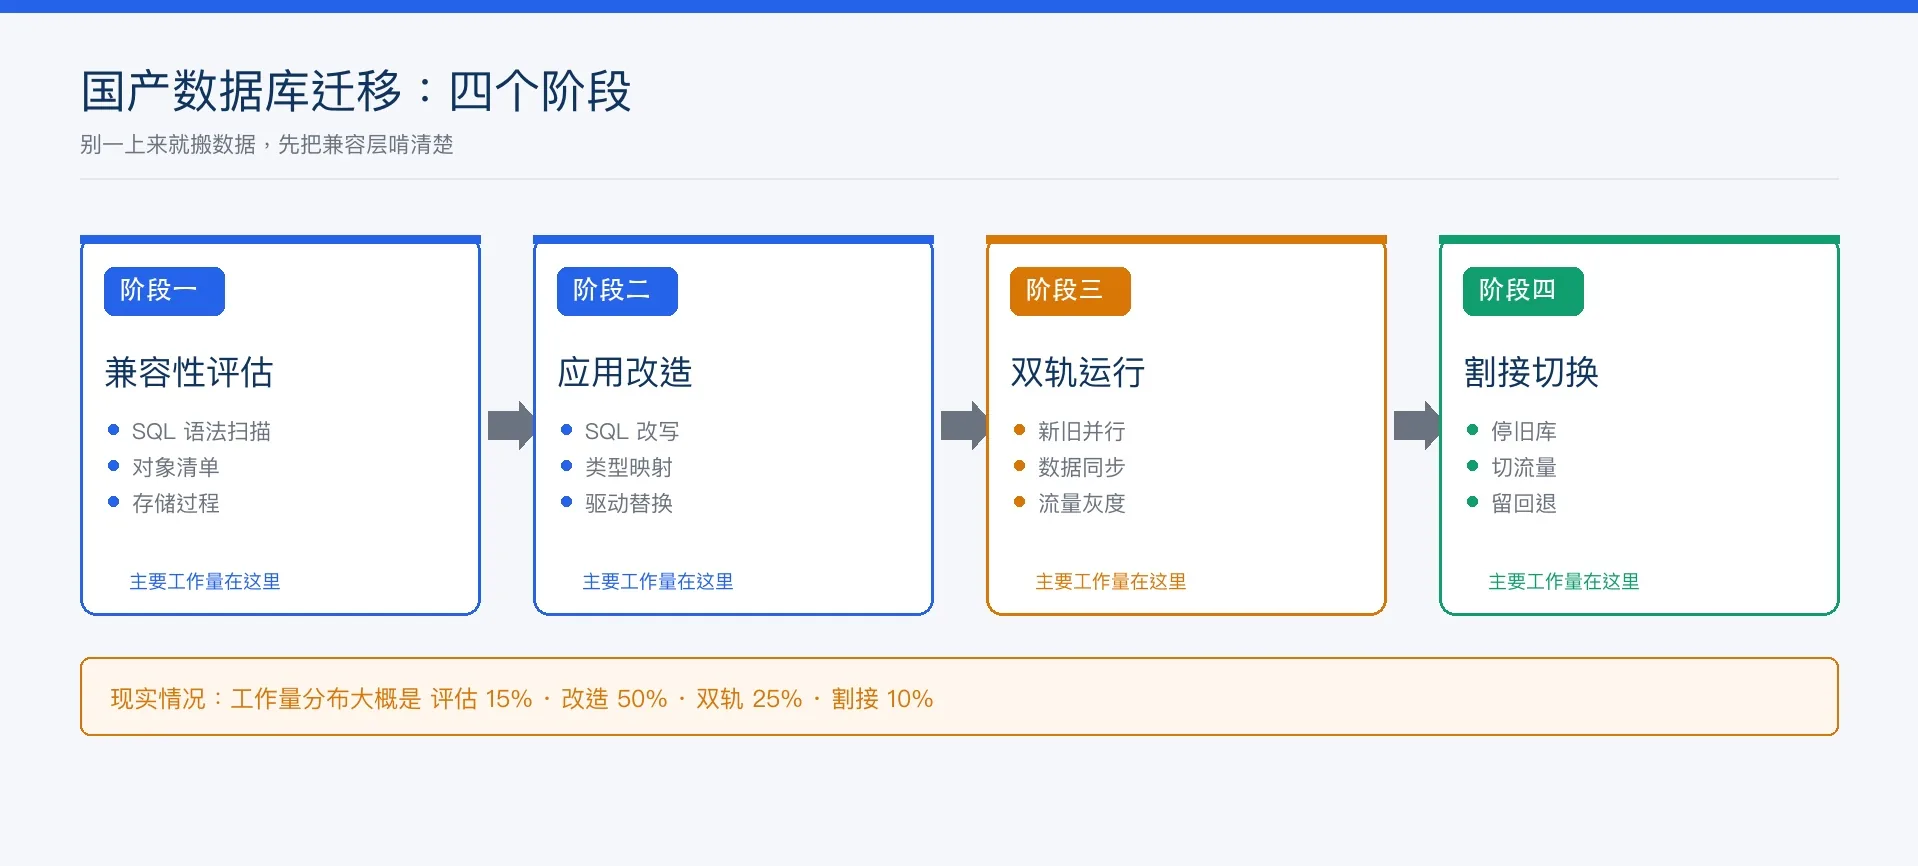
后来我做了个简单的分布统计,四个项目加起来:兼容性评估约 15%,应用改造约 50%,双轨运行约 25%,割接切换约 10%。这个比例基本稳定,可以当默认预期用。
二、先扫 SQL,再动一行代码
评估阶段我会做三件事,顺序不能反。
第一件是全量扫 SQL 语句,包括视图、触发器、存储过程、动态拼接的语句。工具不重要,能把散落的 .sql 文件、代码仓库里的查询、以及数据库导出都汇总进来就行。产出是一张清单,标上每条语句用了哪些不兼容语法。
第二件是列对象清单,重点看索引类型、分区策略、主键定义方式。国产库在索引上的一些限制会直接影响 DDL,拖到后面才发现就得返工。
第三件才是跑真实业务,拿核心场景的典型数据量做一次压测。这一步经常被跳过,但它能提前暴露连接数、并发上限这类问题——这些在功能测试里完全看不出来。
三、几个每次都会撞上的坑
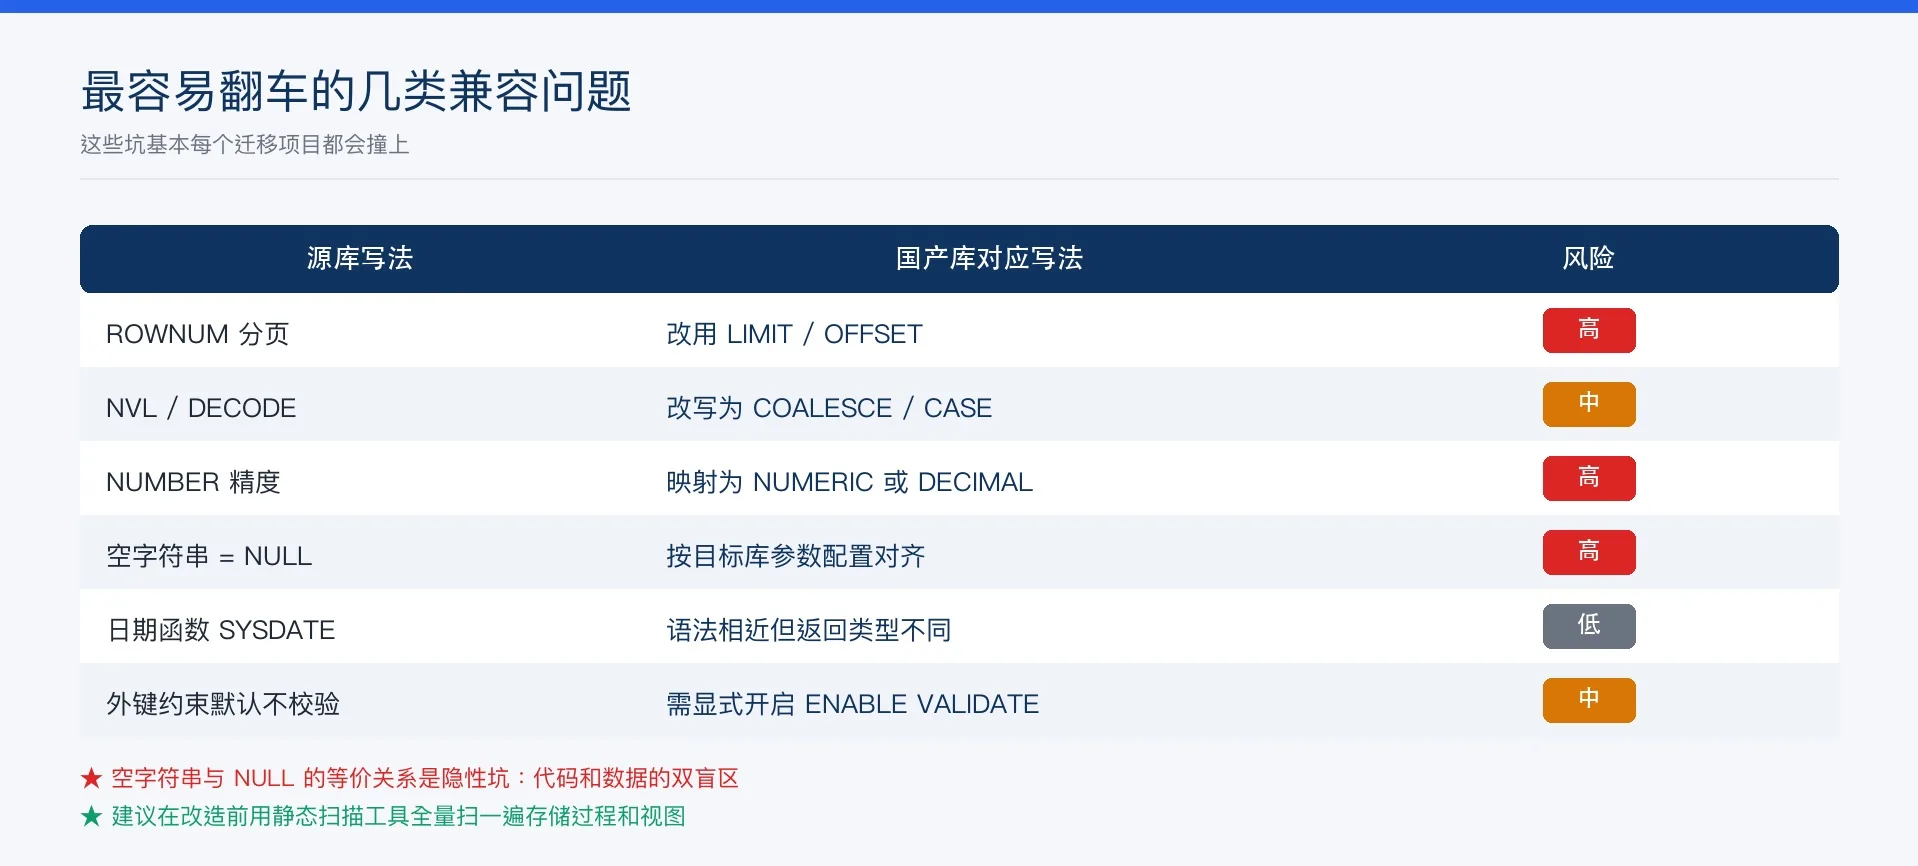
分页写法是第一个。ROWNUM 嵌套两层改 LIMIT/OFFSET,看着机械,但嵌套层级和 ORDER BY 的位置错一个,返回结果就变。改完必须拿生产数据比对,不能只看条数对不对。
空字符串等于 NULL 这个最阴。某些配置下国产库把空串存成 NULL,代码里 if (name != null) 走的分支就变了。这种问题在测试环境可能永远不出现,因为测试数据很少有全空值的字段。
数值精度要提前定死。NUMBER 没写精度和标度,迁到 NUMERIC 上可能变成能存 38 位小数的类型,表体积和索引效率都会变。建议映射时显式指定 NUMERIC(p,s)。
外键约束的默认行为也不一样。有的库默认不校验导入数据,得显式开启校验,不然脏数据会在割接后才暴露。
四、双轨期别只跑通就行
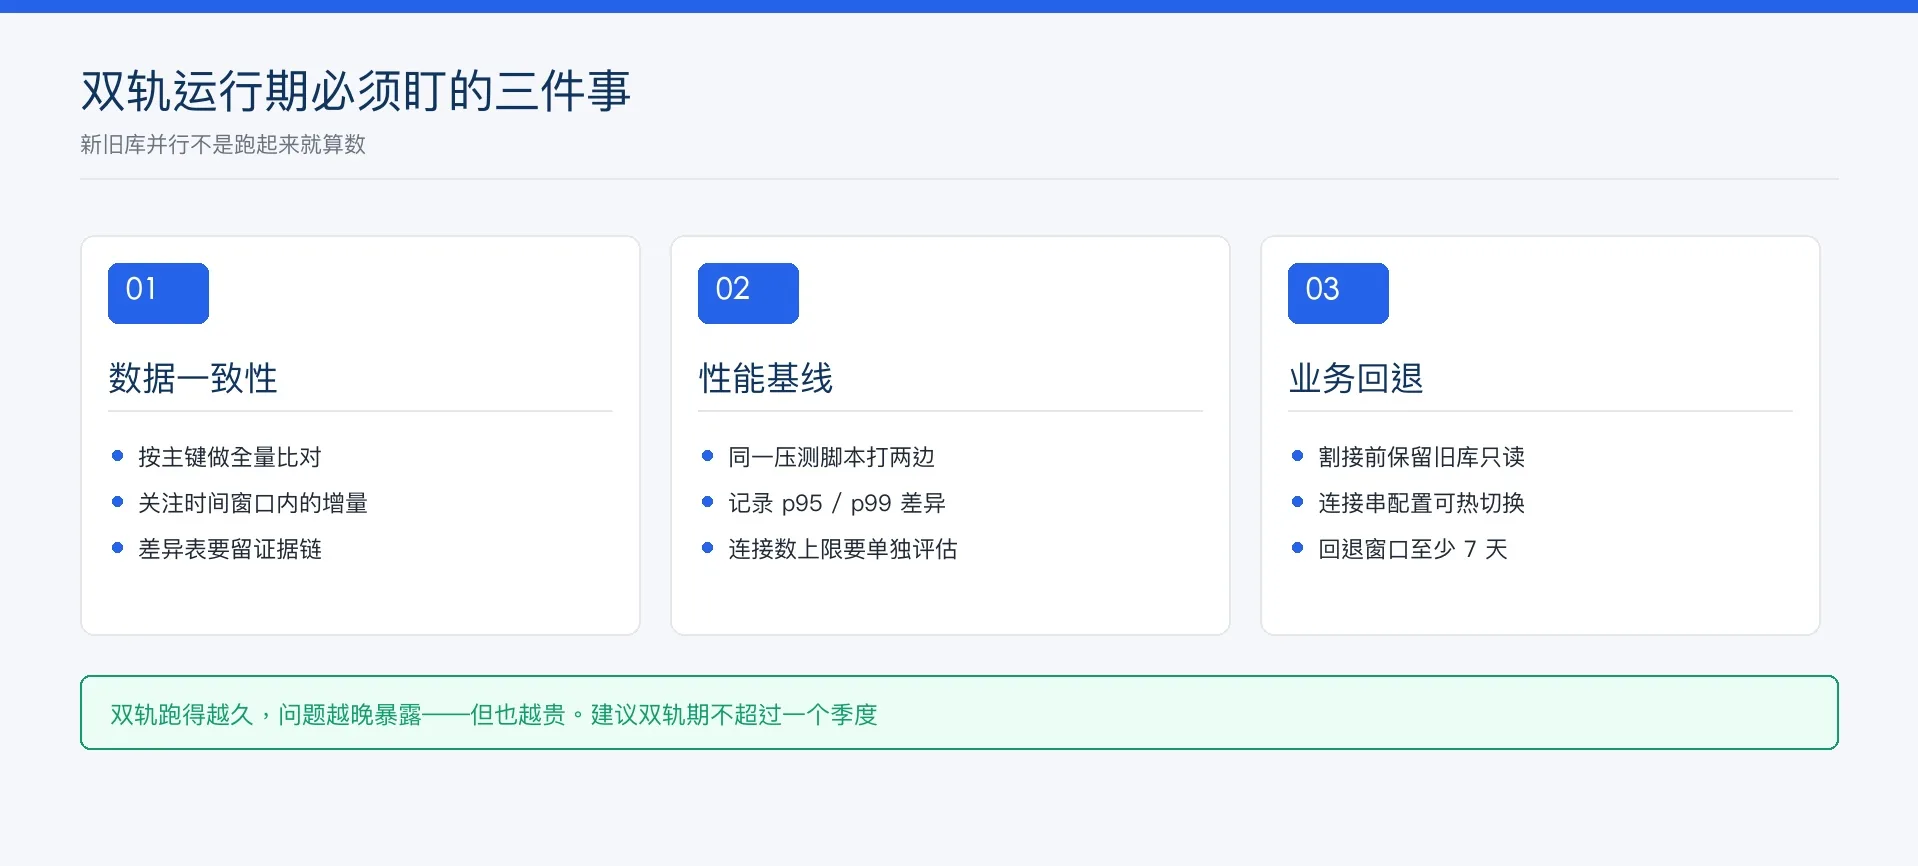
新旧库并行的那段时间,我坚持盯三个指标。
数据一致性按主键做全量比对,增量部分按时间窗口拉。差异表要留着,不要比对完就删——真出问题的时候这份差异清单是唯一的证据链。
性能基线用同一套压测脚本打两边,记录 p95 和 p99 的差异。国产库在连接池配置上通常需要单独调,默认值照搬往往连不上。
回退方案必须提前想清楚。我的习惯是割接后旧库保留只读至少 7 天,连接串配置做成可热切换的,而不是改代码重新发版。
五、有时候该劝人别迁
不是所有系统都值得迁移。这几年遇到过几个项目,评估完的结论是”这个真做不了”。
深度绑定数据库特性的系统首当其冲。存储过程里用了大量数据库特有的包、动态 SQL、系统视图,翻译成本远超重写成本,翻译完还很难验证正确性。
规模特别小的系统也劝过。数据量只有几百 MB,查询简单,国产化带来的收益完全覆盖不了改造成本。这时候保留原库做只读归档,比硬上要合理。
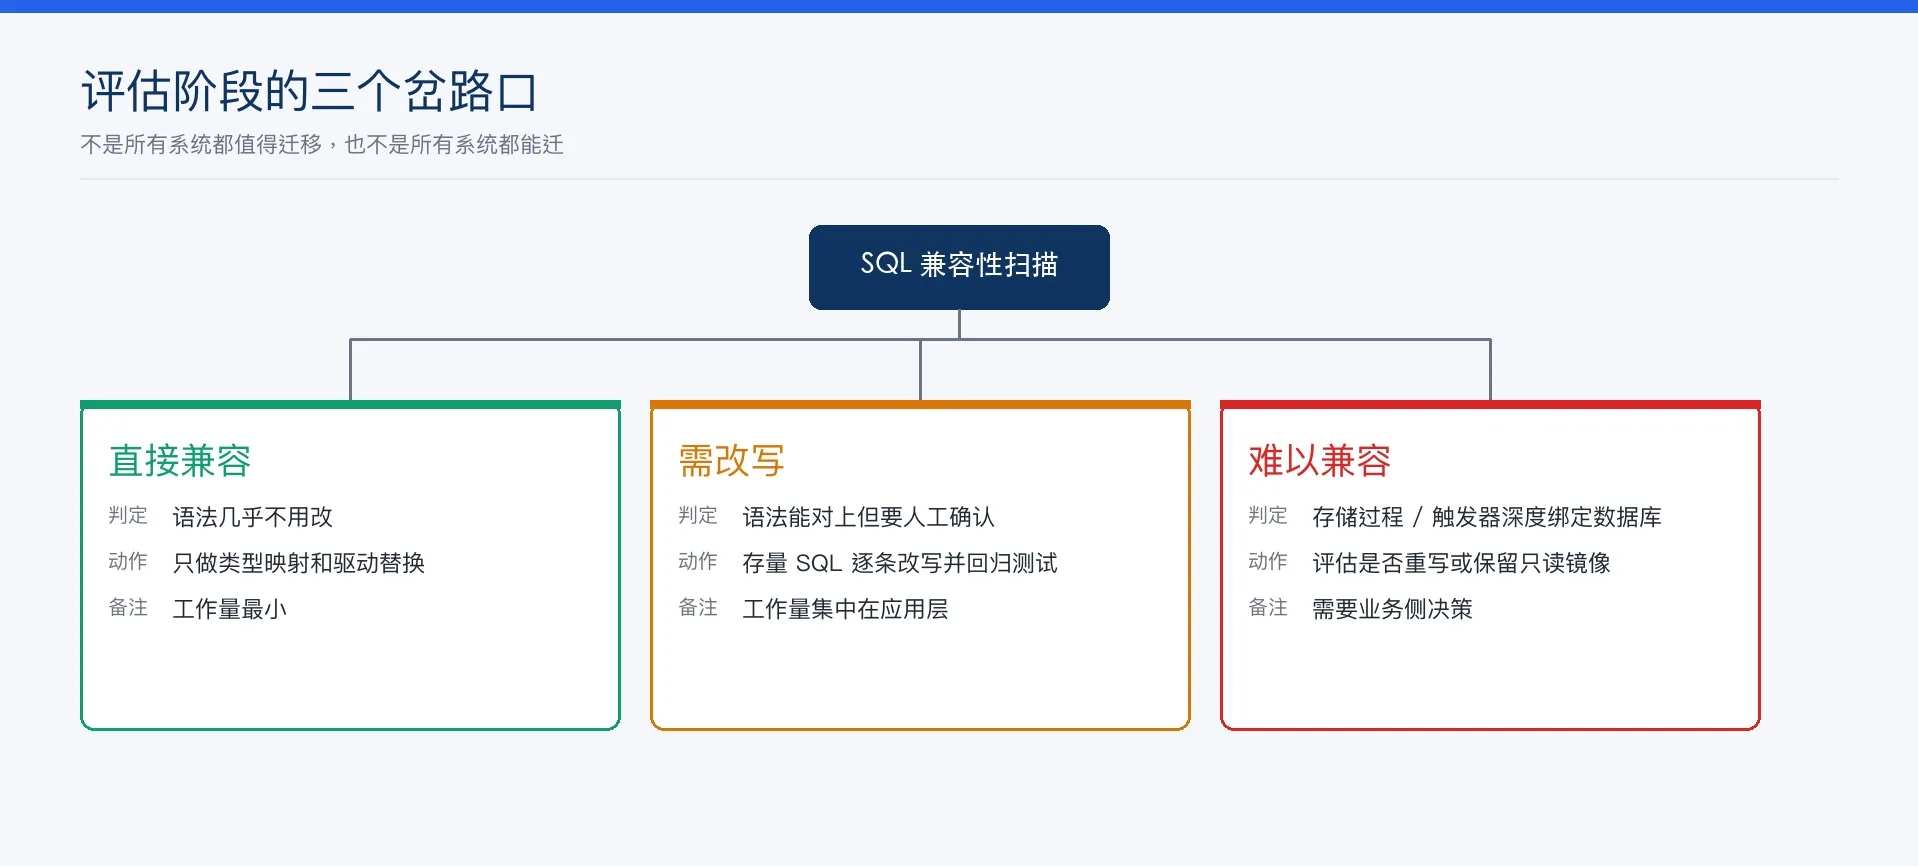
我的判断顺序是这样:先扫 SQL,出清单,按直接兼容 / 需改写 / 难以兼容分三类。第三类里如果有核心业务,就得拿数据去跟业务方谈——这不是技术决策,是投入产出的决策。
迁移项目做得好不好,最后看的是割接那天的回滚次数。回滚为零的项目,前面四个月的评估和双轨都算扎实。
