做交付多了以后,我养成一个习惯:新机器到我手里,不装业务、不建用户,先花二十分钟跑一遍检查。二十分钟能挡掉后面两周的扯皮。这篇把那份清单摊开,每一项都写清楚「为什么查」和「不合格怎么处理」,脚本也一并放出来。

一、最费时间的从来不是装系统

装一台 Linux 机器,真正花时间的步骤只有三分钟。剩下的时间全花在「这台机器到底干不干净」上。

去年验收一批机器,同一批镜像、同一个脚本装完,逐台巡检的时候翻出来的问题五花八门:有一台 /etc/resolv.conf 是上家客户留下的内网 DNS;有一台时间戳差了 40 分钟,装软件直接报证书错误;还有一台 SELinux 是关闭的,说明装机的人图省事顺手关了。这类问题不上线永远发现不了,一上线就是线上事故。

所以我的判断标准很简单:能被脚本查到的问题,就不该靠眼睛看。
二、清单分成三档

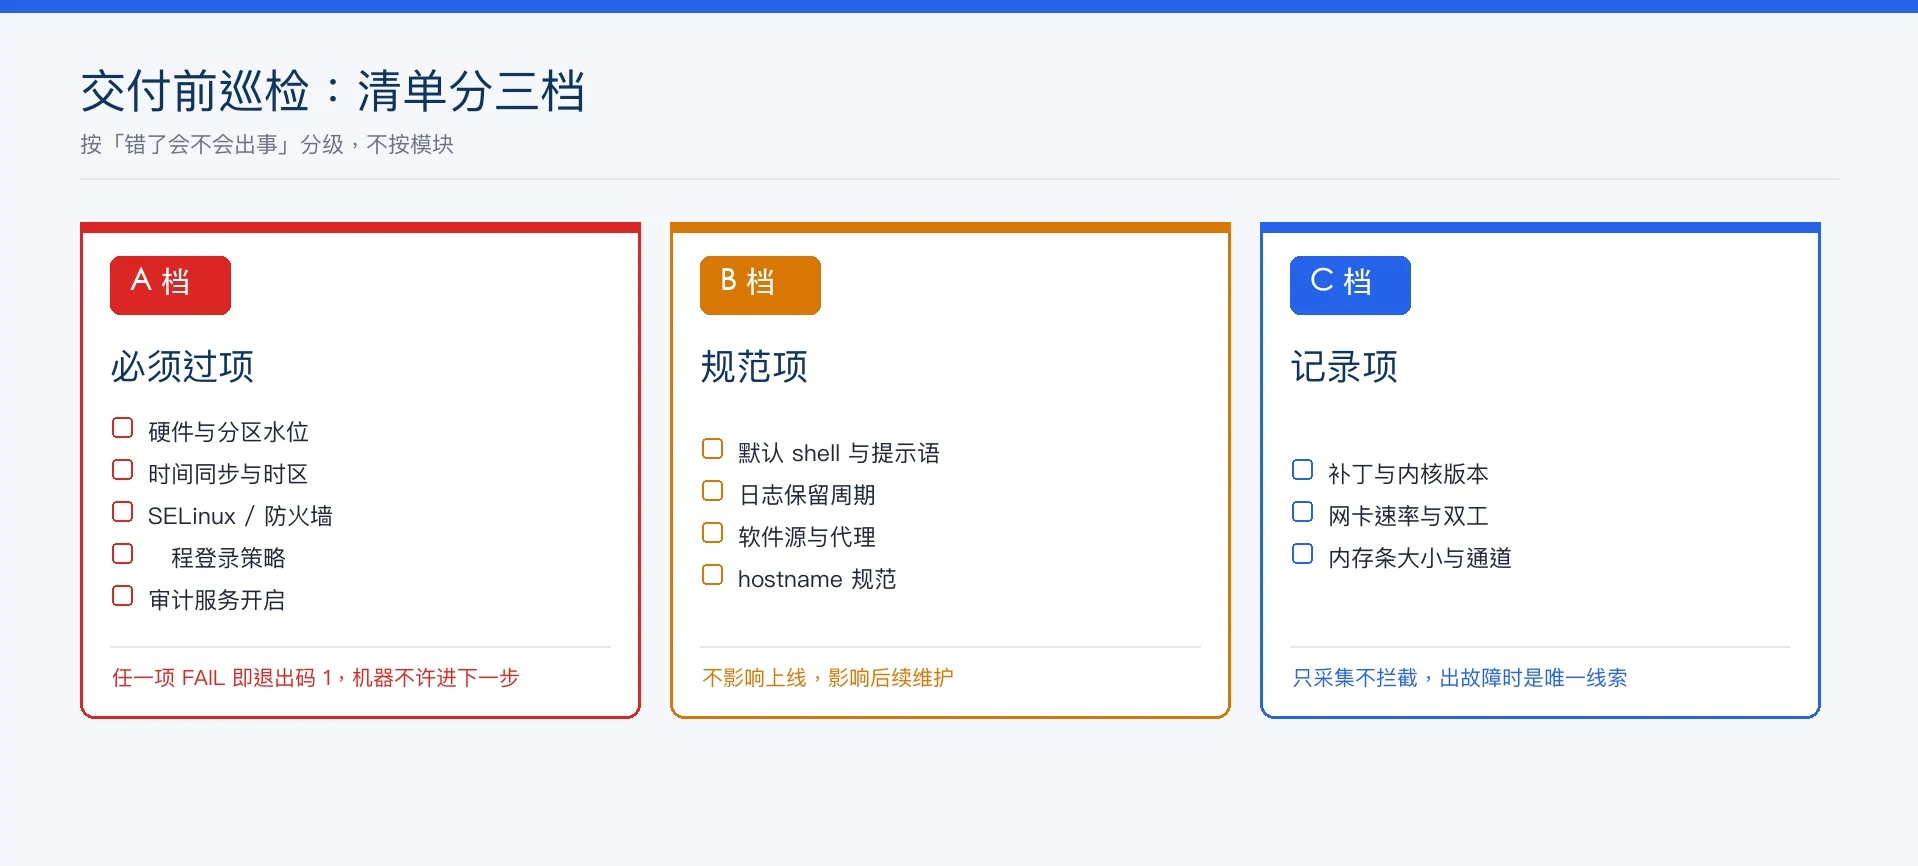
我把检查项按「错了会不会出事」分成三档,不分档就没法决定检查的深度。

A 档是必须过项,任何一项不过这台机器就不能进下一步。硬件状态、分区使用率、时区与时间同步、SELinux 与防火墙状态、远程登录策略、审计服务——这些错了是要出事的,要么影响业务稳定,要么影响合规。

B 档是规范项,不影响上线但影响后续维护。默认 shell、登录提示语、日志保留周期、软件源配置、hostname 规范——这些现在不改,以后就是「历史遗留问题」。

C 档是记录项,只采集不拦截。装了哪些补丁、内核版本、网卡速率、内存条大小。这类的数据在出故障时是唯一的线索。

分档的意义在于:全量脚本跑一遍,把结果按档位分成三种颜色,一眼就知道卡在哪。

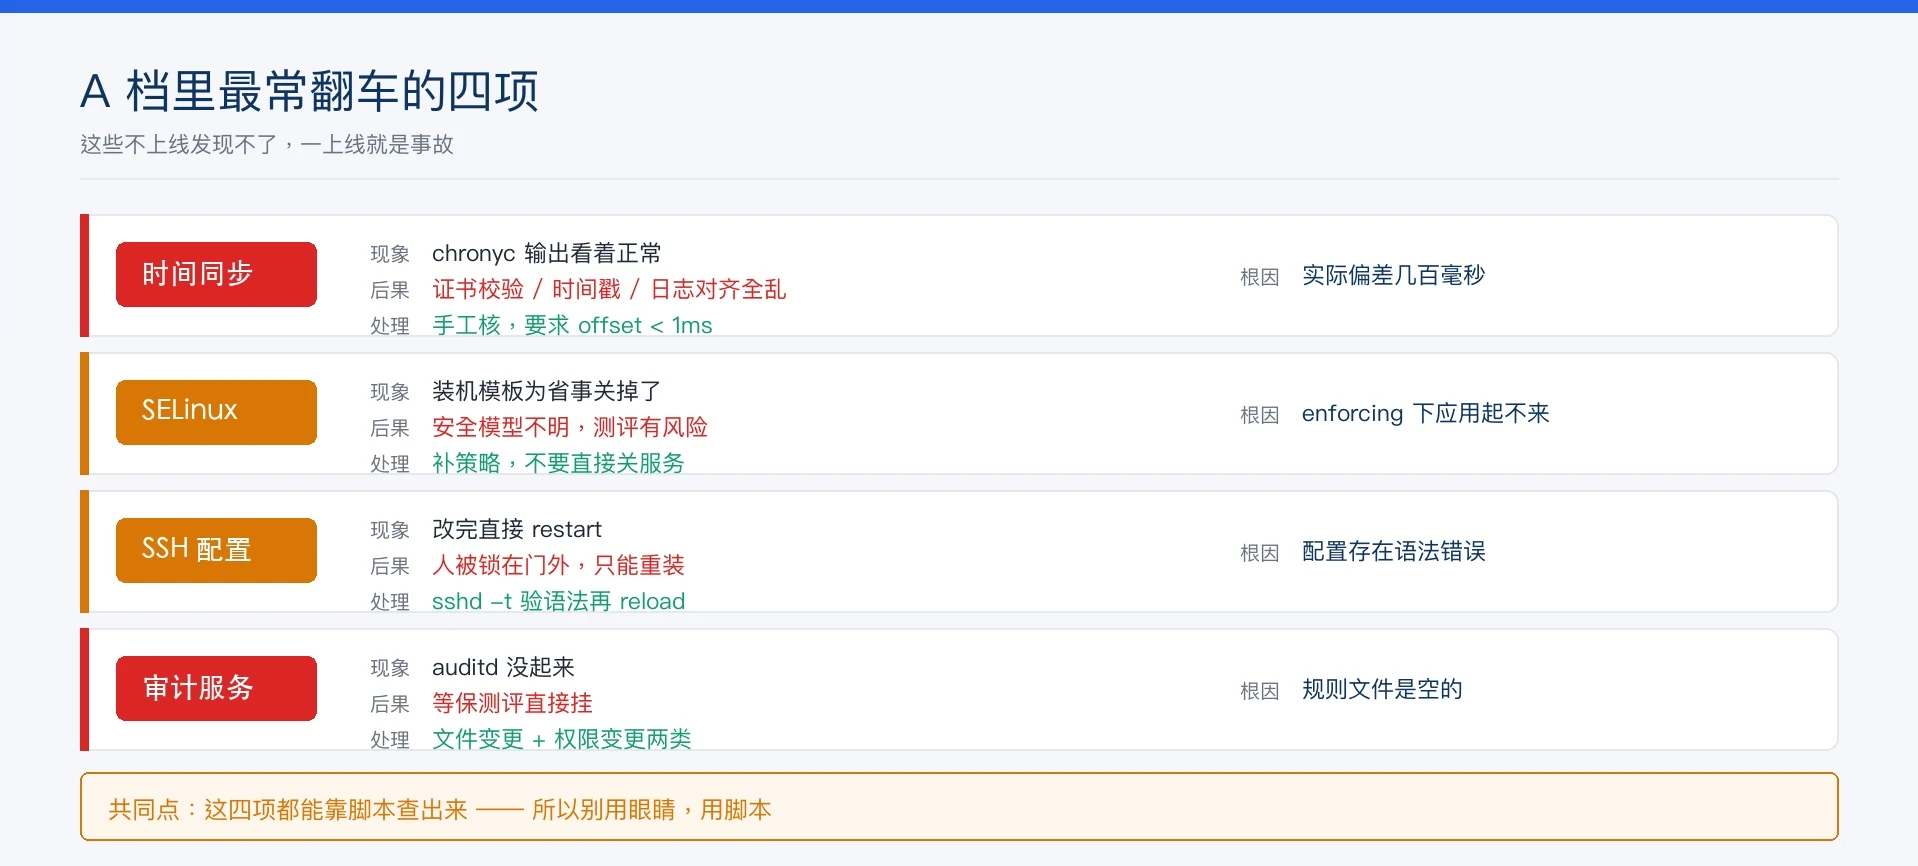
三、A 档里最常翻车的是这几项

时间同步。这一项我从来不放进自动化,就手工核。原因是自动化的 chronyc sources 输出经常看着正常,实际偏差几百毫秒,而证书校验、数据库时间戳、日志对齐对时间敏感的场景,偏差几百毫秒就能出诡异问题。我的做法是同时对两路 NTP 源,并且要求 offset 和 delay 都在 1ms 以内。

SELinux 和防火墙。很多装机模板为了省事把 SELinux 关了,理由是「应用跑不起来」。我的处理方式是反过来:先在 enforcing 模式下跑一遍应用日志,把确实需要的策略补上,而不是把服务关掉。真关掉的话,交付文档里得写清楚原因,否则后面没人知道这机器的安全模型是什么。

SSH 配置。要求密钥登录、禁 root 直连、禁密码爆破。这三项直接改 /etc/ssh/sshd_config,改完一定用 sshd -t 验语法再 reload——直接 restart 遇上语法错误会把人锁在外面,这是个老坑。

审计服务。等保测评里几乎必查。auditd 开着、规则文件里至少有文件变更和用户权限变更两类、审计日志写到独立分区——这三条不过,测评直接挂。
四、脚本怎么写

不用什么框架,bash 就够。我把它写成一个函数库加一个主脚本,主脚本读配置、跑检查、输出报告,报告是 Markdown 的,方便直接贴进交付文档。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
#!/usr/bin/env bash
# precheck.sh —— 交付前巡检,A 档不过即退出码 1

FAIL=0
declare -a RESULT

record() { # $1=档位 $2=项目 $3=状态 PASS/WARN/FAIL $4=说明
RESULT+=("| $1 | $2 | $3 | $4 |")
[[ "$3" == "FAIL" ]] && FAIL=1
}

# --- A1 时区与时间同步 ---
TZ_OK=$(timedatectl show -p NTPSynchronized --value)
[[ "$TZ_OK" == "yes" ]] && record A 时间同步 PASS "已同步" \
|| record A 时间同步 FAIL "未同步,先查 chronyd/ntpd"

OFFSET=$(chronyc tracking 2>/dev/null | awk '/System time/{print $4}' | tr -d 'ms')
if [[ -n "$OFFSET" ]] && awk -v o="$OFFSET" 'BEGIN{exit !(o<1.0)}'; then
record A 时钟偏差 PASS "${OFFSET}ms"
else
record A 时钟偏差 FAIL "偏差 ${OFFSET:-未知},超过 1ms 阈值"
fi

# --- A2 分区使用率 ---
while read -r mp use; do
num=${use%\%}
if (( num >= 85 )); then
record A 磁盘水位 FAIL "$mp 已用 ${use}"
fi
done < <(df -hP | awk 'NR>1 && $6!="tmpfs" && $1 ~ /^\/dev\//{print $6, $5}')

# --- A3 SELinux ---
SE=$(getenforce 2>/dev/null || echo N/A)
[[ "$SE" == "Enforcing" ]] && record A SELinux PASS "Enforcing" \
|| record A SELinux WARN "当前 $SE,需说明原因"

# --- A4 SSH 策略 ---
grep -qE '^PermitRootLogin\s+(no|prohibit-password)' /etc/ssh/sshd_config \
&& record A root直连 PASS "已禁" || record A root直连 FAIL "root 仍可直连"
grep -qE '^PasswordAuthentication\s+no' /etc/ssh/sshd_config \
&& record A 密码登录 PASS "已禁" || record A 密码登录 FAIL "密码登录未禁"
sshd -t && record A sshd语法 PASS "配置合法" || record A sshd语法 FAIL "语法错误,reload 会断连"

# --- A5 审计 ---
systemctl is-active --quiet auditd \
&& record A 审计服务 PASS "运行中" || record A 审计服务 FAIL "未运行"

脚本跑完输出一张表,A 档有 FAIL 就直接退出码 1,交付流程里把这步做成硬卡点。B 档只提示,C 档只记录。

五、检查完了还要留一份快照

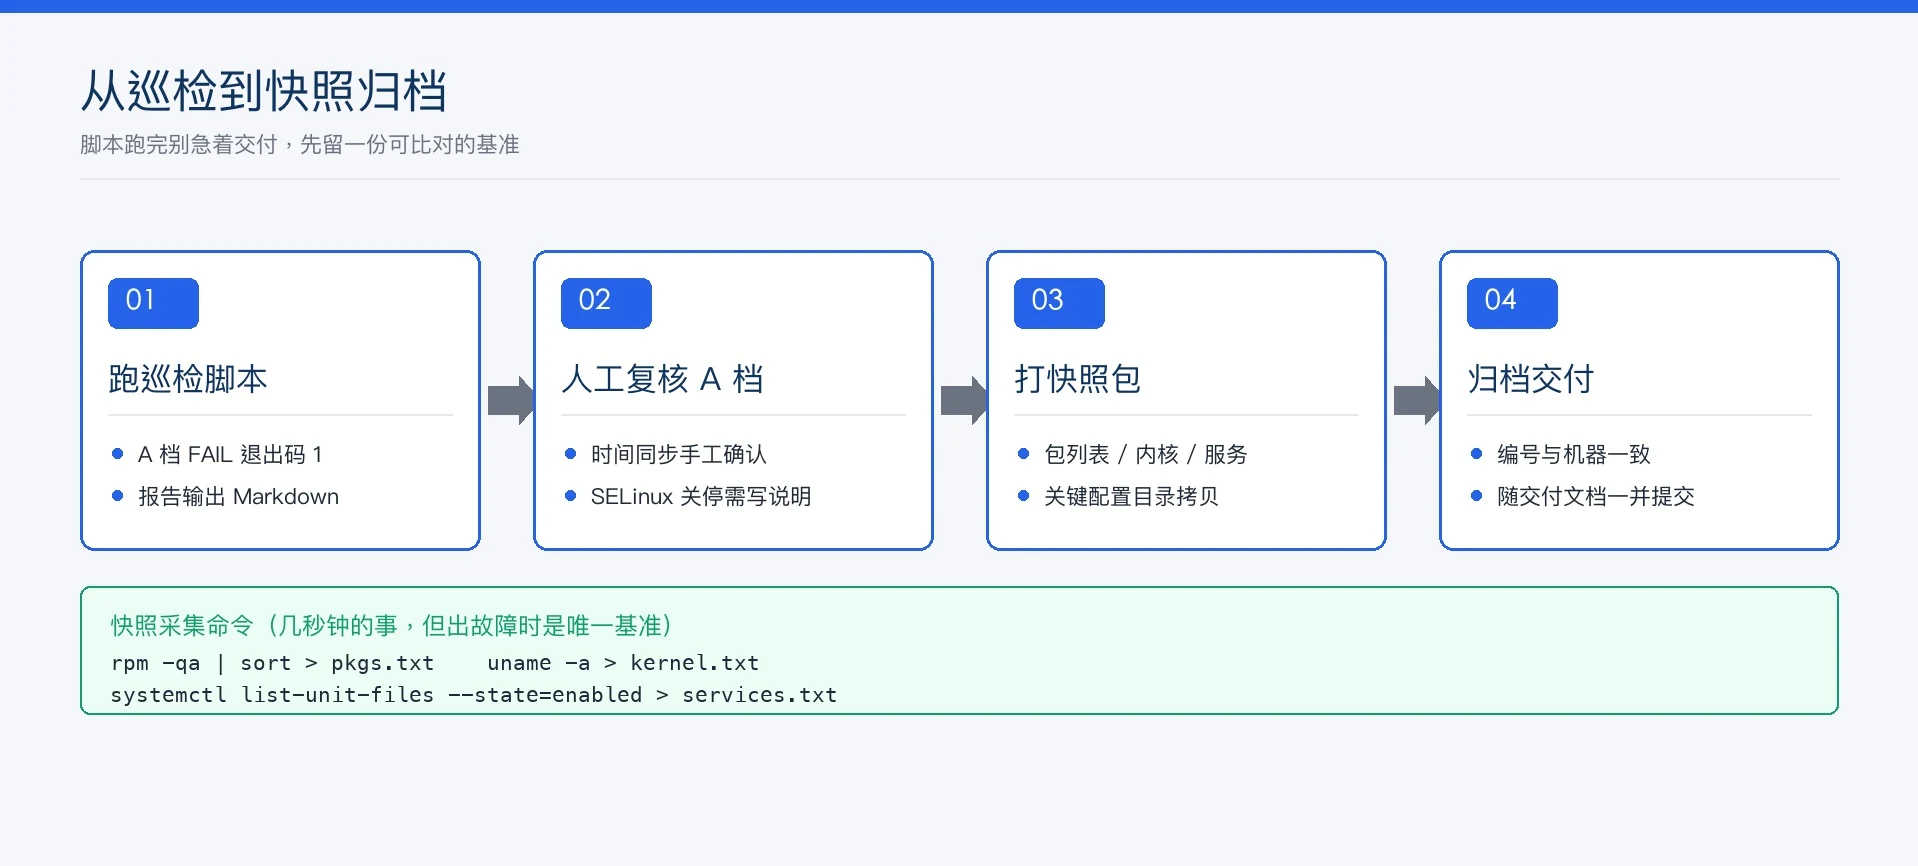
巡检通过不等于完事。我还会在交付前把机器的当前状态打包存一份:已装包列表、内核版本、关键配置项、服务启用状态。这份快照不出问题的时候没人看,出问题的时候是唯一能对比的基准——「上次还好好的,这次内核从 5.14 升到了 6.1」这种信息,比事后翻聊天记录快得多。

打包就是几条命令:

1
2
3
4
5
rpm -qa | sort > pkgs.txt
uname -a > kernel.txt
systemctl list-unit-files --state=enabled > services.txt
cp -a /etc/sysconfig /etc/ssh /etc/security baseline_etc/
tar czf precheck-snapshot-$(date +%F).tar.gz *.txt baseline_etc/

归档编号跟机器编号一致,跟着交付文档一起走。下次再上这台机器,先解一份快照对比,能省掉一半的排查时间。
六、把这套东西沉淀成规范

单台机器的二十分钟,最后会变成一套东西——巡检脚本、清单文档、异常处理 SOP,都放在团队的知识库里共享。新人上手照着跑一遍就能干活,不用等老同事带。

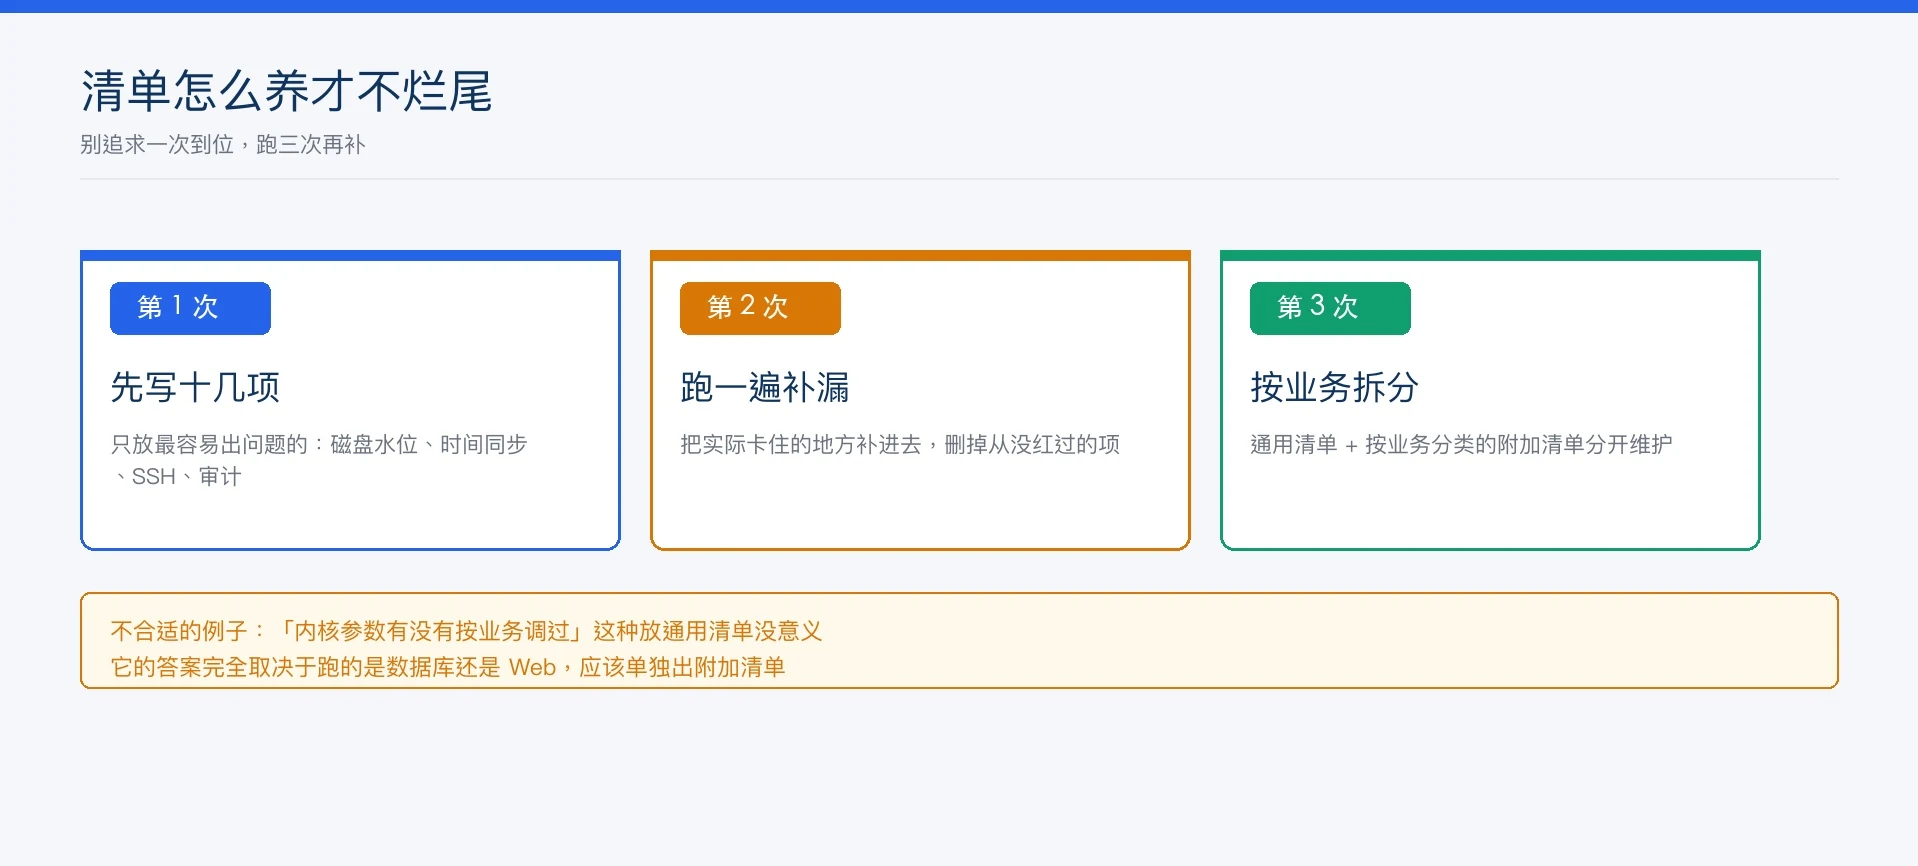
我个人的建议是:清单不要追求一次到位,先写最容易出问题的十几项,跑三次再补。像「内核参数有没有按业务调过」这种需要结合具体应用的检查项,放在通用清单里没意义,应该单独出一份按业务分类的附加清单。
这套东西跑了半年多,最实在的变化是——交付会上争论「这台机器到底有没有问题」的时候,翻报告就行,不用靠记性。

站内搜索

没有找到内容!